页面是什么样,截出来就是什么样
page.screenshot() 交回一个 Buffer,page.pdf() 直接给你一份可打印的文档。整页、可视区、单个元素,位置和尺寸都由你指定。
Puppeteer 把一个真实的浏览器交到你手里。
几行代码就能让它打开页面、按下按键、读出任何一个元素。它运行在 Node.js 上,默认无头——没有窗口,也不需要显示器。
你可以把它放进 CI,也可以放进一台没有图形界面的服务器。
底层是 Chrome DevTools Protocol,或者 WebDriver BiDi。同一套 API 既能驱动 Chrome,也能驱动 Firefox。
这个站按官方 Introduction 分类逐篇翻译,API 名称与代码保留英文原文。
想直接动手,去安装;想先弄清楚它在做什么,继续往下读。
下面四张图不是配图,是用 Puppeteer 真的跑出来、再截下来的。
page.screenshot() 交回一个 Buffer,page.pdf() 直接给你一份可打印的文档。整页、可视区、单个元素,位置和尺寸都由你指定。
Puppeteer 把“任何改变 URL 的行为”都算作导航,包括锚点跳转与 History API。等页面稳定再返回,是默认行为。
一次 setViewport 调用,页面立刻按 390 × 844 重排。移动端布局的回归测试不必依赖真机,也不必手动拖窗口。
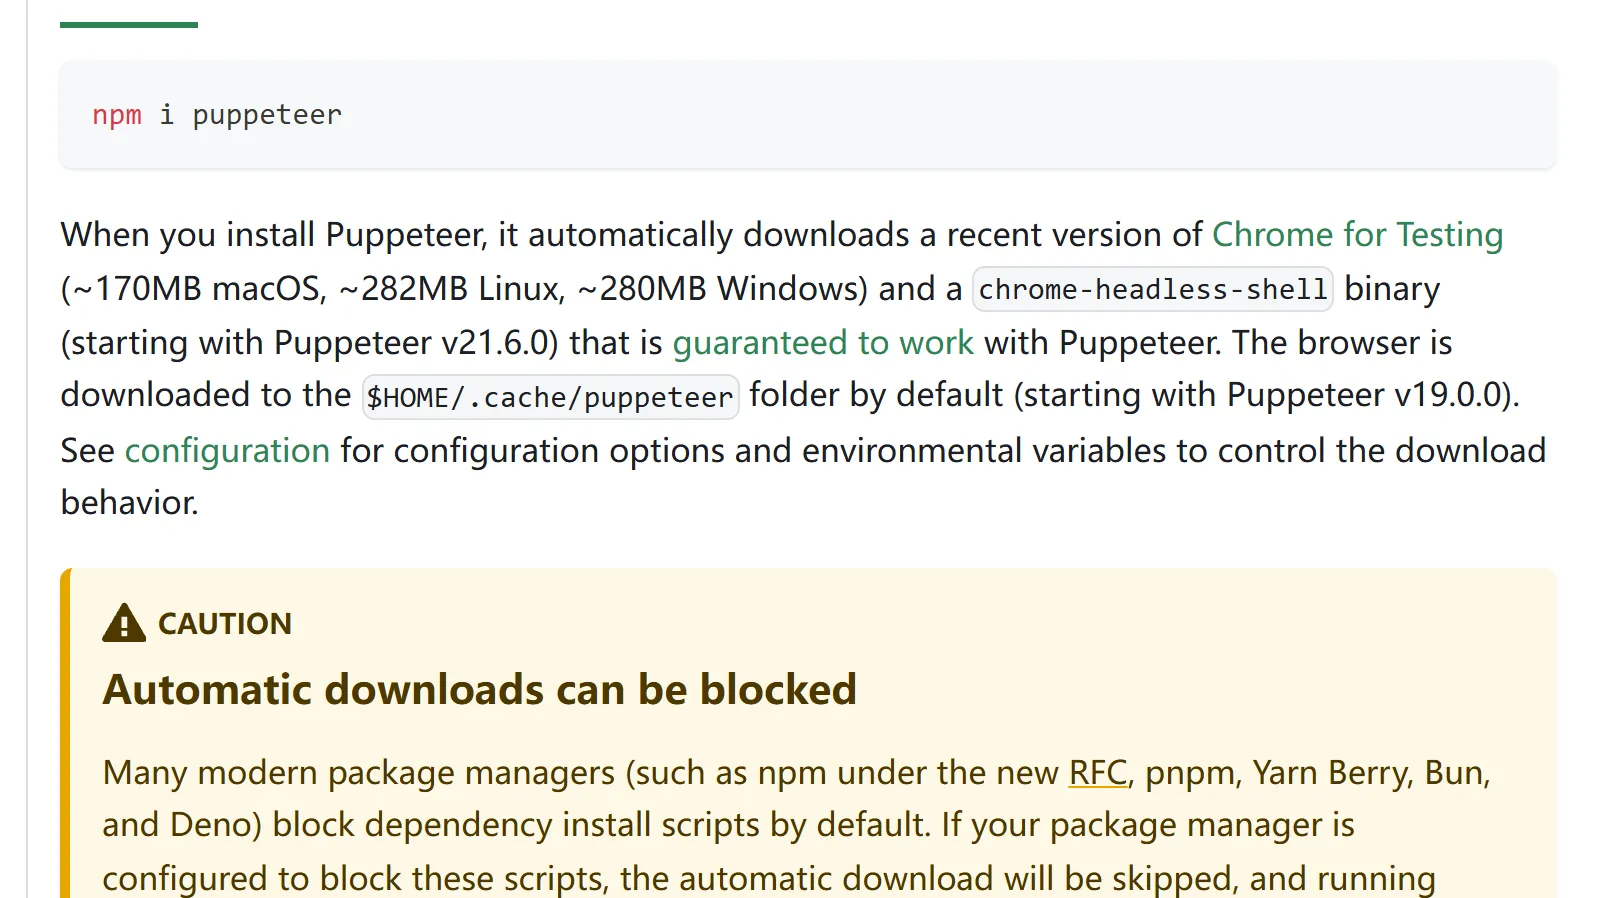
安装时自动下载 Chrome for Testing 与 chrome-headless-shell,版本与库锁定。如果包管理器拦了安装脚本,跑一次 npx puppeteer browsers install。
先启动一个浏览器。
puppeteer.launch()
再开一个空白页。
browser.newPage()
像用户一样操作它。
page.goto() · locator()
最后关掉它。
browser.close()
选中这一行
把视口定成这个尺寸。截图、媒体查询、布局都按它重算。
Page.setViewport
它打印出什么
$ node search.mjs
The title of this blog post is "Customize and automate".1.30百万像素
1440 × 900 × 4 字节 = 4.94 MB 的未压缩帧缓冲。page.screenshot() 默认输出 PNG,体积通常只有它的几分之一。
Chrome Browser Automation 团队维护这个库,不过我们也很欢迎你的帮助与专业经验!见贡献指南。
从 Puppeteer v23.0.0 起,Puppeteer 同时支持 Chrome 与 Firefox。
自动化 Chrome 时,Puppeteer 默认使用 Chrome DevTools Protocol(CDP),但也可以用 WebDriver BiDi 来驱动;自动化 Firefox 时默认使用 WebDriver BiDi。API 支持上的细微差异,见 WebDriver BiDi 指南。
从 Puppeteer v23.0.0 起,Puppeteer 对 WebDriver BiDi 的支持已可用于生产,可驱动 Chrome 与 Firefox。
会。尽管 Puppeteer 已经支持 WebDriver BiDi,我们并不会停止用 CDP 自动化 Chrome。这样既不破坏依赖 CDP 的既有自动化,也能继续支持那些 Chrome 独有、尚未被 WebDriver BiDi 标准化的用例。
项目的目标是:
我们借鉴 Chromium 的原则来做产品决策:
Puppeteer 是一个基于 Node.js 的参考实现,演示如何用 CDP 与 WebDriver BiDi 自动化浏览器——而 Selenium 项目也在为同一套 Web 标准做贡献。
Selenium 项目在多个方面超出了 Puppeteer 的范围:它为 JavaScript 之外的语言提供绑定,还提供像 Selenium Grid 这样大规模编排自动化的工具。这两者都超出了 Puppeteer 的职责范围。
有一些社区项目在核心之外为 Puppeteer 增加能力,让测试等事情更方便,例如 jest-puppeteer 或 Puppeteer 的 Angular 集成。